
Hello, 各位 iT 邦幫忙 的粉絲們大家好~~~
這系列文源自這幾年在團隊裡導入 AI Coding 之後,一路踩雷、修正、再踩雷的真實過程。把這些收斂出來的方法整理成文,也許對正在煩惱同樣問題的你會有些幫助。
就當作是一份邊做邊記的工程筆記吧!
本篇是 當 AI 加入團隊:打造可審查、可驗證、會自我改善的 AI 開發工作流 系列文的 EP02。
上一篇提到,我們想讓 AI 的行為變成團隊共用的資產。
「資產」這詞雖然看起來很抽象,實踐的第一步其實很土炮:
構建出團隊成員都看得懂的骨架,這樣做的目的是讓不同性質的內容都有各自可去的歸屬。
所以,這套 AIOrchestrations 工具箱就這樣拆成這幾個目錄結構來組成:
AIOrchestrations/
├── workflows/   端到端的工作流程(輸入 → 步驟 → 輸出 → 完成條件)
├── agents/      需要協調多個能力的角色設定
├── skills/      單一、可重複使用的能力
├── prompts/     固定用途的提示樣板
├── scripts/     真正會被執行的輔助腳本
├── knowledge/   已審查過、可重複使用的領域知識
├── docs/        給人與給 AI 看的說明文件
└── schemas/     驗證上述檔案格式的 JSON Schema
這個分工看起來很直覺(?)
但這有用的地方,在於它回答了一個很實際的問題:當 AI 要處理一個任務時,它該去哪裡找「該做什麼」、去哪裡找「怎麼做」、又去哪裡找「哪些事絕對不能做」?
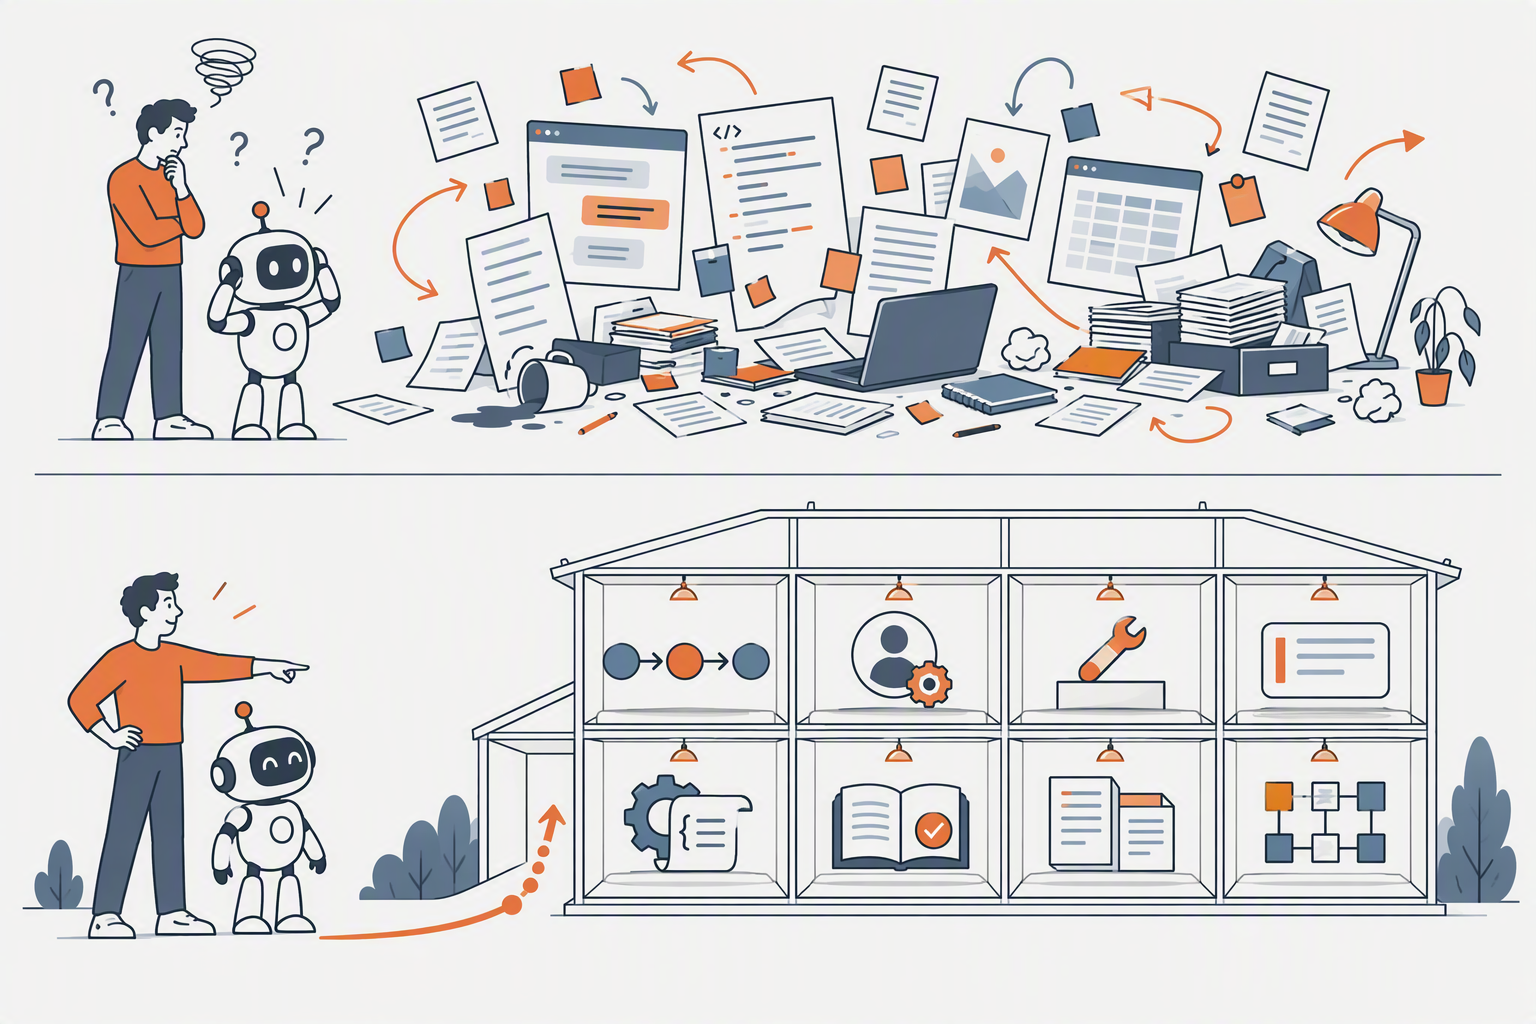
刻意不在這個階段就把所有規則寫死成一份巨大的說明文件。
這個骨架的價值不在於一開始就完備,而在於團隊的每個成員。
對,每個成員
無論這個成員是 人 還是 Agent
不用讀完整個 Repository,就能大概猜到「這件事該去哪裡找」。
之後每當我們發現一種新的重複性工作,第一個問題永遠是:「這應該放進 workflows/、skills/,還是 knowledge/?」這個習慣本身,就是讓整套工具箱不會失控膨脹的第一道防線。
骨架有了,第一批真正長出來的 "肌肉" 又是什麼呢?下一篇見。


 iThome鐵人賽
 看影片追技術